 Cart is empty
¿Qué es llms.txt y por qué nació?
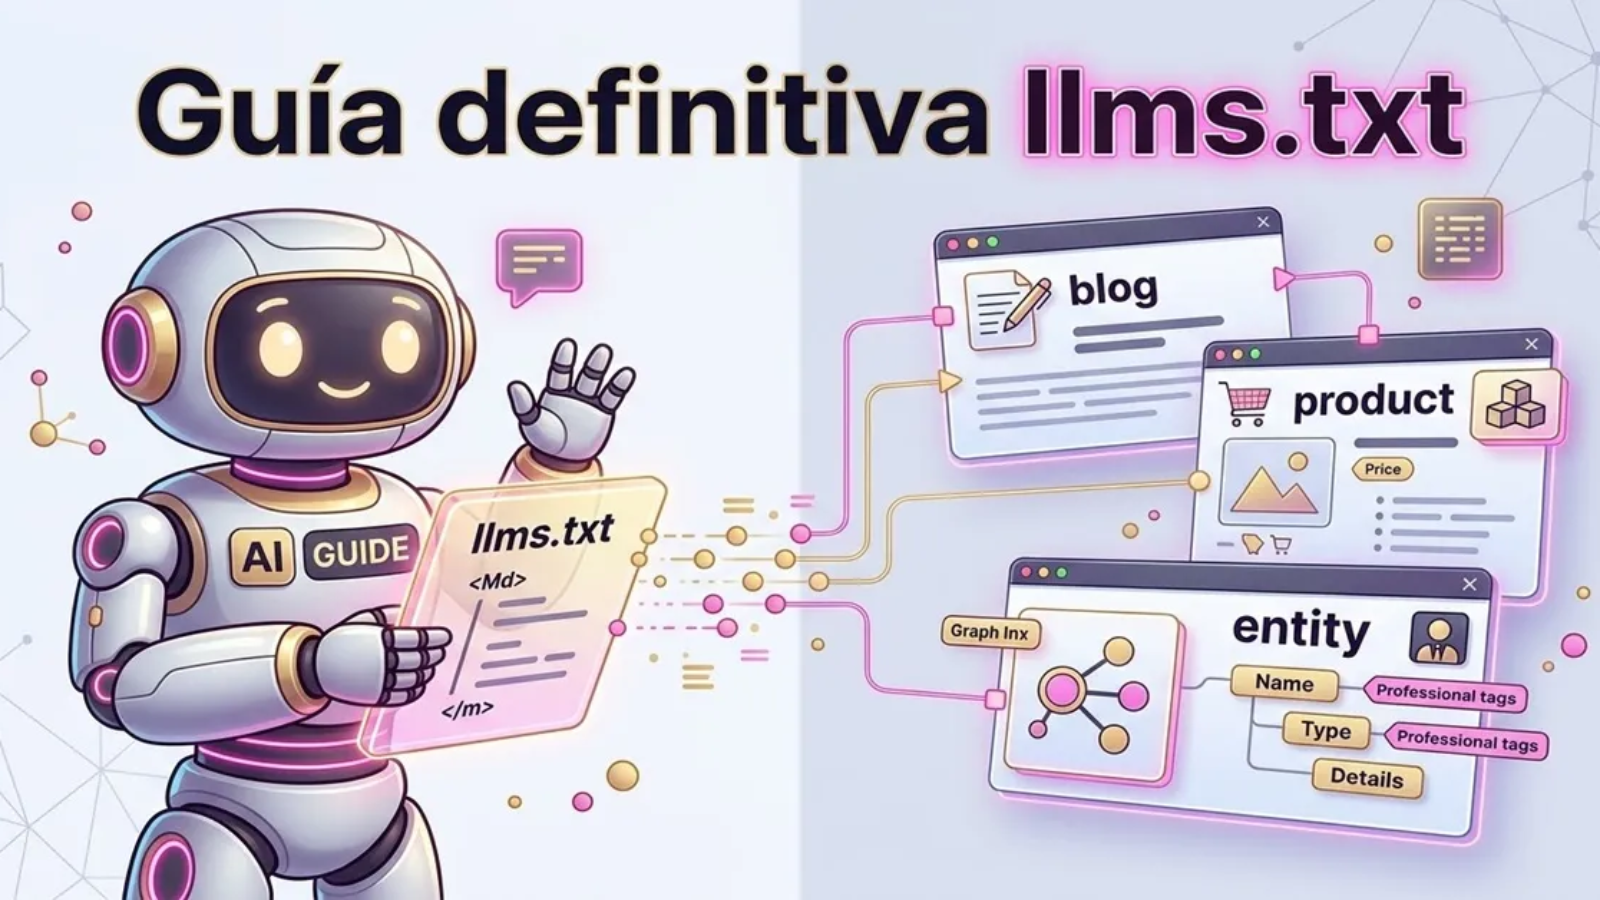
llms.txt es un archivo de texto plano, alojado en la raíz de tu dominio, que le dice a los modelos de lenguaje (LLMs) qué contenido de tu web es relevante, cómo está estructurado y qué deben citar. Es el equivalente al sitemap.xml, pero diseñado para la inteligencia artificial generativa en lugar de los rastreadores tradicionales de Google.
El estándar fue propuesto en 2024 por Jeremy Howard (cofundador de fast.ai) como respuesta a un problema concreto: los LLMs necesitan contexto de alta calidad para responder, pero leer una web completa en cada consulta es caro, lento y ruidoso. Un archivo llms.txt resuelve esto entregando a la IA un resumen estructurado y curado de tu sitio, en un formato que puede procesar en milisegundos.
Piensa en ello como un briefing ejecutivo para la IA: en lugar de obligar al modelo a rastrear cientos de páginas, adivinar cuáles importan y tropezar con menús, banners y código irrelevante, le entregas un mapa limpio con lo esencial. El resultado es que la IA te cita con más precisión, con menos alucinaciones y con tu mensaje intacto.
La diferencia entre llms.txt, sitemap.xml y robots.txt
Es el error más común: asumir que llms.txt reemplaza a los archivos que ya tienes. No es así. Cada uno cumple una función distinta y los tres conviven:
| Archivo | Para quién | Qué comunica | Formato |
|---|---|---|---|
robots.txt | Rastreadores (bots) | Qué NO deben indexar | Directivas de exclusión |
sitemap.xml | Buscadores (Google, Bing) | Qué URLs existen | Lista de URLs + metadatos |
llms.txt | Modelos de lenguaje (LLMs) | Qué contenido es relevante y cómo citarlo | Markdown estructurado |
La diferencia clave es semántica: sitemap.xml le dice a un buscador dónde están tus páginas; llms.txt le dice a una IA qué significan y cuál es la fuente autoritativa. El primero es un inventario; el segundo, una curaduría.
Por qué las palabras clave ya no bastan
Durante dos décadas, el SEO se construyó sobre un supuesto: si optimizas una página para una palabra clave, el buscador la mostrará cuando alguien la busque. Ese modelo se está rompiendo. En Google AI Overviews, ChatGPT y Perplexity, el usuario ya no hace clic en diez resultados azules: recibe una respuesta sintetizada, y la IA decide qué fuentes merecen ser citadas.
Las herramientas que usas hoy — Semrush, Ahrefs — te dicen qué keywords rankean y quién te supera, pero no te dicen si una IA va a citarte. Miden el ranking, no la citabilidad.
Los motores generativos no leen palabras clave; comparan y resuelven grafos de conocimiento. Cuando una IA responde “¿qué empresa chilena ofrece GEO para WordPress?”, no busca la página con más densidad de la frase “GEO WordPress Chile”. Busca la entidad que esté mejor definida, mejor anclada y mejor descrita en un formato que pueda procesar sin ambigüedad.
Ahí es donde llms.txt se vuelve estratégico: es el canal directo por el que le entregas a la IA tu versión de los hechos, sin depender de que un rastreador la infiera de tu HTML.
Cómo funciona llms.txt por dentro
Un archivo llms.txt válido es Markdown plano con una estructura mínima y predecible. Comienza con un bloque H1 que identifica el sitio, seguido de un bloque de citas con el resumen ejecutivo, y luego una lista de enlaces a las secciones o documentos clave:
# SemanticGEO

> Plugin de GEO para WordPress que evoluciona Yoast SEO hacia
> un grafo de conocimiento con anclaje a Wikidata y llms.txt automático.

- [Qué es GEO](https://semanticgeo.com/que-es-geo): definición y fundamentos.
- [Entity SEO](https://semanticgeo.com/entity-seo): cómo anclar tu marca a Wikidata.
- [Precios](https://semanticgeo.com/planes-y-precios): planes para agencias y consultores.
La clave está en la disciplina de curaduría: no enlazas todo, enlazas lo que define tu autoridad. Cada enlace es una declaración de relevancia. Y cuando el archivo se sincroniza con tu grafo de conocimiento, cada URL apunta a una entidad bien definida, no a una página suelta.
Nota de Entidad: de texto libre a dato estructurado
Aquí está la diferencia entre “mencionar” y “anclar”. Un texto que dice “somos una consultora SEO en Chile” es solo una frase. Pero cuando esa misma afirmación se emite con un Q-ID verificado de Wikidata, deja de ser una opinión y se convierte en un dato estructurado irrebatible que la IA puede resolver contra su propio grafo.
En la práctica, inyectar un Q-ID transforma la frase en un bloque JSON-LD de Schema.org, algo así:
{
  "@type": "ProfessionalService",
  "name": "Tu Consultora",
  "knowsAbout": {"@id": "https://www.wikidata.org/wiki/Q180711"},
  "areaServed": {"@id": "https://www.wikidata.org/wiki/Q298"}
}
Aquí Q180711 es el identificador real de search engine optimization y Q298 el de Chile en Wikidata. No son números inventados: son entidades que existen en el grafo global y que cualquier motor puede resolver. La diferencia es que SemanticGEO se conecta a la API de Wikidata y valida cada Q-ID en tiempo real — un dígito equivocado te conectaría a una entidad ajena, y el plugin lo impide. Cero errores, cero entidades fantasma.
Ese anclaje es el puente que conecta tu entidad local con el grafo global. Sin él, tu llms.txt describe; con él, demuestra. Y es exactamente el tipo de señal que los motores generativos priorizan al decidir a quién citar.
Cómo implementar llms.txt en WordPress
Existen tres caminos, de menor a mayor sofisticación:
- Manual: crea un archivo
llms.txten la raíz de tu servidor y mantenlo a mano. Funciona, pero se desincroniza en cuanto publicas contenido nuevo. - Con un generador: usa una herramienta que lo produzca a partir de tu sitemap. Mejor, pero sigue sin entender la semántica de tu contenido.
- Automatizado y semántico: un sistema que genere el
llms.txtdirectamente desde tu grafo de conocimiento, sincronizado con cada entidad y cada publicación.
El tercer camino es el único que escala, porque elimina el trabajo manual y garantiza que el archivo siempre refleje la versión más actual y más autoritativa de tu sitio.
La solución tecnológica: SemanticGEO
SemanticGEO resuelve este problema de raíz. En lugar de pedirte que escribas y mantengas un llms.txt a mano, lo genera automáticamente y lo sincroniza con tu grafo de conocimiento. Cada entidad que defines, cada anclaje a Wikidata y cada publicación se refleja en el archivo sin que tengas que tocar una línea.
Y aquí está lo que lo hace único en el mercado: SemanticGEO se conecta a la API de Wikidata y valida cada entidad en tiempo real. Cuando importas un pack de nicho o buscas una entidad, el Q-ID y la URL de Wikipedia se verifican contra la API pública en el momento — un dígito equivocado te conectaría a una entidad ajena, y el plugin lo impide. Cero errores, cero identificadores sin validar. Esa es la diferencia entre “escribir schema” y “operar un grafo verificable”.
Esto significa que la IA siempre recibe un resumen técnico sin ambigüedades: tu marca bien definida, tus servicios bien anclados y tu autoridad bien demostrada. Y como SemanticGEO evoluciona Yoast SEO (gratuito) aplicando Graph Stitching sobre su estructura, no tienes que abandonar tu flujo de trabajo actual: lo potencias.
Con 13 packs de nicho importables y cero tipeo manual, pasas de “escribir contenido optimizado” a “operar una infraestructura de conocimiento” que los motores generativos pueden leer, resolver y citar.
Preguntas frecuentes sobre llms.txt
¿llms.txt reemplaza a mi sitemap.xml?
No. Son complementarios. El sitemap.xml sigue siendo necesario para los buscadores tradicionales; el llms.txt añade una capa semántica específica para los modelos de lenguaje. Un sitio bien optimizado para GEO mantiene ambos.
¿Google usa llms.txt para sus AI Overviews?
Google no ha confirmado oficialmente que lea llms.txt, y conviene ser honesto: llms.txt es un estándar emergente que aún no está confirmado por los proveedores de LLMs. Lo que sí está demostrado es que los motores generativos consumen contenido estructurado y grafos de entidades. El archivo llms.txt es adoptado por un ecosistema creciente de herramientas y asistentes, y su valor principal es entregar a cualquier LLM una versión curada de tu sitio. Es una señal de preparación para la era generativa, no un reemplazo del SEO clásico ni una garantía de citación.
¿Qué es llms-full.txt?
Es una variante que, en lugar de un resumen curado, contiene el texto completo de tu documentación o contenido, pensada para que los LLMs puedan entrenar o responder con el contexto íntegro. Se enlaza desde el llms.txt principal como recurso complementario.
¿Necesito conocimientos técnicos para implementarlo?
No necesariamente. La implementación manual es sencilla (un archivo de texto en la raíz), pero mantenerlo sincronizado con tu contenido y tu grafo de conocimiento sí requiere automatización. Herramientas como SemanticGEO lo generan y actualizan por ti.
Conclusión: la puerta de entrada a la era generativa
El SEO no está muerto, pero su centro de gravedad se está moviendo. Donde antes bastaba con palabras clave y enlaces, ahora se impone la capacidad de definir entidades, anclarlas a grafos globales y entregarlas a la IA en un formato que pueda resolver sin ambigüedad. El archivo llms.txt es la pieza que conecta esos tres movimientos.
Si tu objetivo es que ChatGPT, Perplexity o Google AI Overviews citen tu empresa como fuente autoritativa, el primer paso es dejar de depender de la inferencia y empezar a entregar la respuesta. Y eso empieza con un llms.txt que no escribes a mano, sino que emerge de tu grafo de conocimiento.
Domina los motores generativos desde WordPress
SemanticGEO genera tu llms.txt automáticamente, sincronizado con tu grafo de conocimiento y tus anclajes a Wikidata. Sin tipeo manual, sin desincronización.