 Cart is empty
Método paso a paso, basado en el estudio de Princeton sobre GEO, para escribir contenido que ChatGPT, Perplexity y Google AI Overviews citen como fuente.
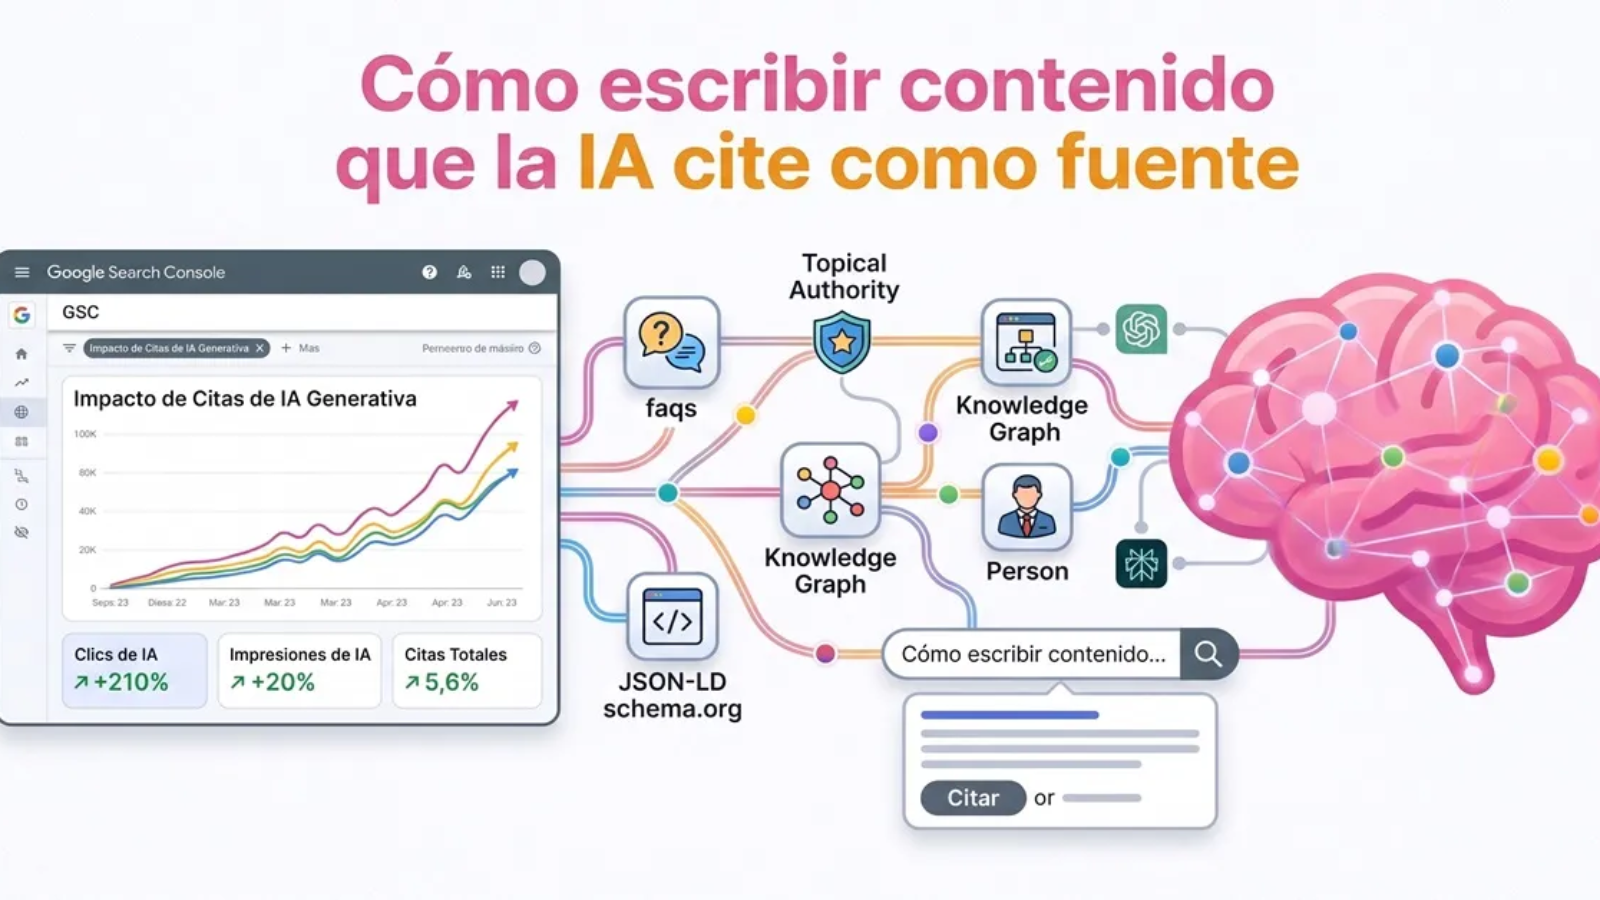
Método paso a paso, basado en el estudio de Princeton sobre GEO, para escribir contenido que ChatGPT, Perplexity y Google AI Overviews citen como fuente.
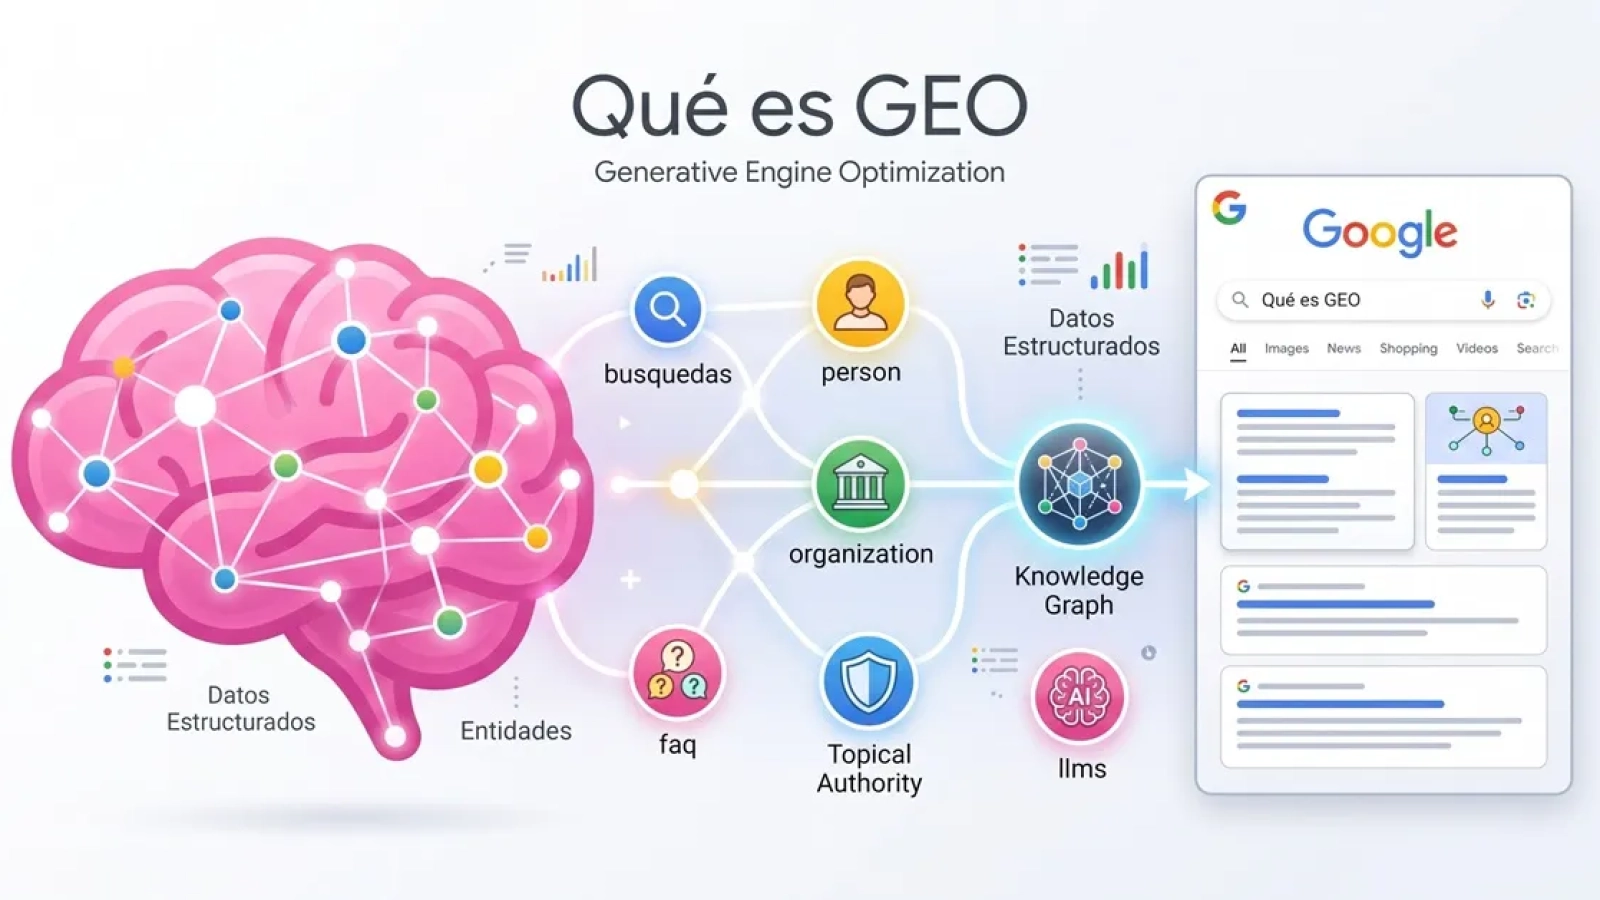
El GEO (Generative Engine Optimization) es la disciplina que optimiza un sitio web para que los motores generativos ChatGPT, Google AI Overviews, Perplexity, Gemini lo interpreten, confíen en él y lo citen al responder una pregunta. A diferencia del SEO clásico, que compite por una posición en una lista de diez enlaces azules, el GEO compite por ser la fuente que la IA elige nombrar dentro de su respuesta. Y el dato que lo cambia todo: en febrero de 2026, según BrightEdge, solo el 17% de las citaciones de Google AI Overviews provenían del top 10 orgánico. Estar bien posicionado ya no basta para que te citen; ni estarlo mal te excluye.
El GEO optimiza para la citación: que un modelo generativo incluya tu marca, tu dato o tu enlace dentro de la respuesta que redacta. El SEO tradicional optimiza para el ranking: que tu página aparezca lo más arriba posible en una lista de resultados. Son dos juegos distintos con dos ganadores distintos.
La diferencia no es cosmética. En el SEO clásico, el usuario ve diez enlaces y decide en cuál hacer clic; tu trabajo era llegar a esa lista y destacar en ella. En un motor generativo no hay lista: hay una respuesta única, redactada por un modelo de lenguaje, que menciona un puñado de fuentes y omite todo lo demás. No compites por un puesto en la página; compites por existir dentro del párrafo que el modelo escribe.
Ese cambio reordena qué señales importan. El SEO recompensaba la relevancia de palabras clave y la autoridad de enlaces. El GEO recompensa algo más profundo: que el motor pueda resolver quién eres como entidad qué sabes hacer, dónde operas, quién te respalda y que tu contenido sea fácil de extraer y de citar. El marco conceptual completo detrás de esta transición es el SEO semántico y el funcionamiento del Knowledge Graph; el GEO es su aplicación al terreno de los motores generativos.
Una nota terminológica útil: verás las siglas GEO, AEO y SGE usadas casi como sinónimos. No lo son del todo. AEO (Answer Engine Optimization) se enfoca en ganar el snippet y la respuesta de voz; SGE era el nombre inicial de la experiencia generativa de Google, hoy AI Overviews. GEO es el paraguas: optimizar para cualquier motor que genere una respuesta citando fuentes.
Porque la respuesta generativa dejó de ser un experimento y se comió la parte alta de la búsqueda. Según datos de BrightEdge, en el primer trimestre de 2026 los AI Overviews de Google aparecían en cerca del 48–50% de las búsquedas en Estados Unidos una expansión de casi ocho veces frente al 6,49% de enero de 2025. La pregunta ya no es si la IA intermedia a tu cliente, sino si te menciona cuando lo hace.
El impacto en el tráfico es medible y duro. Pew Research documentó que, con un AI Overview presente, los usuarios hacen clic en un resultado tradicional solo el 8% de las veces, frente al 15% cuando no lo hay. El clic orgánico se comprimió a la mitad. Para un negocio que dependía del tráfico de búsqueda, eso es la mitad de las visitas evaporándose en el resumen que la IA muestra antes de tus enlaces.
Y aquí está el hallazgo que obliga a repensar la estrategia entera: la fuente que la IA cita ya casi no coincide con quien rankea. BrightEdge midió que en febrero de 2026 apenas el 17% de las citaciones de AI Overviews venía del top 10 orgánico, frente al 76% a mediados de 2024. Un análisis independiente de OrganiKPI sobre 153.425 citaciones de IA llegó al mismo lugar por otro camino: el 76,95% de las URLs citadas no estaban en el top 10 de su propia consulta.
Las tres señales que más aumentan la probabilidad de que un motor generativo te cite son, por este orden: citar fuentes creíbles, incluir estadísticas concretas e incorporar citas textuales de autoridades. No es una opinión de agencia: es el resultado del primer estudio académico sobre el tema, el paper «GEO: Generative Engine Optimization» de Aggarwal y colaboradores (Princeton e IIT Delhi, 2023).
El estudio probó nueve estrategias sobre 10.000 consultas en un sistema de recuperación aumentada simulado, validado además contra Perplexity real. Sus conclusiones, cuantificadas:
Igual de valioso es lo que no funcionó. El keyword stuffing el reflejo clásico del SEO de repetir la palabra clave mostró poca o ninguna mejora. Y el tono autoritario aplicado en aislamiento tampoco movió la aguja. Los motores generativos no cuentan repeticiones: evalúan si tu contenido aporta evidencia citable.
Esa es la mitad de contenido de la ecuación. La otra mitad es de infraestructura: para citar a una empresa, el motor primero necesita resolverla como entidad. Aquí es donde entra el Entity SEO: anclar tu empresa al Knowledge Graph con Wikidata. Un contenido impecable sobre una empresa que el motor no puede identificar como entidad verificable rinde por debajo de su potencial, porque la IA duda de a quién está citando.
Una estrategia de GEO que funciona opera en tres capas simultáneas: contenido extractable, autoridad de entidad e infraestructura técnica. La mayoría de las guías cubren solo la primera. Las tres se refuerzan; ninguna basta por sí sola.
Es la capa que documenta el paper de Princeton: citar fuentes, incluir estadísticas y citas textuales, responder la pregunta en la primera oración de cada bloque. El objetivo es que un fragmento de tu página pueda copiarse dentro de una respuesta y seguir teniendo sentido por sí solo.
Su límite: el mejor contenido del mundo sobre una empresa que el motor no reconoce como entidad se cita menos de lo que debería.
Que el motor sepa quién eres: una organización con nombre legal, cobertura, servicios y un autor real y verificable detrás del contenido. En un estudio de mayo de 2026 sobre 988 consultas, los perfiles de LinkedIn aparecieron 2.267 veces como fuente de desambiguación de entidades corporativas la evidencia externa que un sistema usa para confirmar que existes.
Su herramienta: el anclaje de entidades con identificadores verificados. Es el terreno del Entity SEO.
Es la capa que convierte las dos anteriores en algo que la máquina lee sin ambigüedad: Schema.org emitido como un solo grafo coherente en JSON-LD, entidades ancladas con doble sameAs a Wikipedia y Wikidata, cobertura territorial tipada y autoría conectada por @id.
Es exactamente lo que hace SemanticGEO sobre WordPress: se engancha a los filtros de Yoast y extiende el grafo existente mediante Graph Stitching, sin duplicar nodos ni fragmentar tu entidad. La mayoría de los sitios “tiene schema”, pero emite bloques aislados que no construyen una entidad resoluble. Comparamos las opciones del mercado en la guía de plugins de GEO para WordPress.
«¿Cómo hago que ChatGPT recomiende mi empresa?» Para que ChatGPT recomiende tu empresa necesitas tres cosas a la vez: contenido que cite fuentes y aporte datos concretos las tácticas que la investigación demuestra que funcionan, una identidad de entidad que el motor pueda verificar contra bases de conocimiento públicas, y datos estructurados limpios que expresen ambas cosas sin ambigüedad. Ningún proveedor puede garantizar la recomendación, porque los modelos deciden a quién citar con criterios propios y cambiantes; lo que sí se puede es implementar con rigor los factores que estos motores declaran y demuestran consumir. Eso aumenta tus probabilidades, no compra un resultado.
Ningún plugin, agencia ni consultor puede garantizar que ChatGPT, Perplexity o Google AI Overviews citen tu marca. Quien lo prometa está vendiendo algo que no controla. Los modelos generativos deciden a quién citar con criterios propios, no publicados y cambiantes de una versión a otra. El GEO mejora tus probabilidades implementando los factores que estos motores declaran y demuestran consumir; no compra una aparición.
Tres precisiones más que la mayoría del mercado se guarda:
llms.txt no tiene adopción confirmada. John Mueller, de Google, escribió en junio de 2025: “FWIW no AI system currently uses llms.txt”, y en junio de 2026 lo calificó de “purely speculative”, con preferencia declarada por el enfoque WebMCP. Implementarlo cuesta casi nada y no tiene riesgo, pero venderlo como factor de ranking confirmado sería deshonesto.Una recomendación explícita contra nuestro propio interés comercial: si tu sitio aún no tiene el SEO técnico resuelto, no empieces por el GEO. Instala primero una base sólida Yoast o una alternativa y vuelve a esta guía cuando los cimientos estén puestos. El comprador técnico valora exactamente esta sobriedad; es lo que separa una estrategia de una promesa.
El orden correcto para implementar GEO va de los cimientos hacia arriba: primero el SEO técnico, luego la identidad de entidad, después el contenido extractable y, por último, la medición. Saltarse el orden es la causa número uno de esfuerzo desperdiciado.
Títulos, metadescripciones, sitemap, velocidad y un grafo de Schema mínimo funcionando. Si usas WordPress, Yoast SEO en su versión gratuita cubre este piso. Sin esto, nada de lo que construyas encima rinde.
Define tu organización una sola vez nombre legal, dirección, cobertura, perfiles oficiales y ancla los conceptos, lugares y personas de tu negocio a identificadores de Wikidata que ya existen. No necesitas una entrada propia en Wikidata para hacerlo; el detalle está en la guía de Entity SEO.
Aplica lo que el paper de Princeton demostró: cita fuentes, sustituye afirmaciones vagas por estadísticas, incorpora citas textuales y responde cada pregunta en la primera oración de su bloque. Estructura el contenido en chunks autosuficientes que un motor pueda extraer sin perder el sentido.
Audita periódicamente si los motores te mencionan, aceptando que la señal es ruidosa. Busca tendencias a lo largo de semanas, no veredictos de una sola consulta. Y recuerda que la ausencia de cita no siempre es culpa tuya: a veces el motor simplemente no encontró la pregunta que te favorece.
El GEO no reemplaza al SEO: se construye encima de él. El SEO tradicional optimiza para que tu página aparezca en la lista de resultados; el GEO optimiza para que un motor generativo cite tu marca dentro de su respuesta. Comparten cimientos técnicos velocidad, indexación, datos estructurados pero persiguen resultados distintos. Un sitio con buen SEO técnico y sin GEO queda invisible en las respuestas de IA; un sitio con GEO sobre cimientos débiles rinde por debajo de su potencial. Necesitas ambos.
No, nadie puede garantizarlo. Los motores generativos deciden a quién citar con criterios propios, no publicados y cambiantes entre versiones, así que cualquier proveedor que prometa una aparición garantizada está vendiendo algo que no controla. Lo que sí se puede hacer es implementar con rigor técnico los factores que estos motores declaran y demuestran consumir: contenido con fuentes y datos, entidades verificables y datos estructurados limpios. Eso mejora tus probabilidades de forma real; no compra un resultado.
El primer estudio académico sobre GEO, de Aggarwal y colaboradores en Princeton e IIT Delhi (2023), probó nueve estrategias sobre 10.000 consultas. Las tres más efectivas fueron citar fuentes creíbles, añadir estadísticas concretas e incorporar citas textuales de autoridades, cada una con hasta un 30–40% de mejora en visibilidad. En cambio, el keyword stuffing repetir la palabra clave mostró poca o ninguna mejora. La conclusión es clara: los motores generativos premian la evidencia citable, no la densidad de palabras.
No es obligatorio, pero acelera mucho la capa técnica. El GEO en WordPress se puede hacer a mano editando el JSON-LD, aunque es laborioso y propenso a errores silenciosos un identificador de entidad equivocado no genera ningún aviso de validación. Un plugin especializado automatiza el anclaje de entidades, la verificación de identificadores y la coherencia del grafo en todo el sitio. Lo que el plugin no hace es escribir tu contenido ni resolver tu SEO técnico base: eso sigue siendo trabajo tuyo.
Es pronto para medir retorno con precisión, pero tarde para ignorarlo. En el primer trimestre de 2026 los AI Overviews de Google aparecían en cerca del 48–50% de las búsquedas en Estados Unidos, según BrightEdge, y el clic orgánico se comprimió a la mitad cuando están presentes. Esperar a que la medición sea perfecta significa ceder ese espacio a los competidores que se muevan antes. La ventaja del GEO es que sus cimientos contenido con fuentes y entidades verificables también refuerzan tu SEO y tu autoridad, así que la inversión no se pierde aunque el panorama siga cambiando.
SemanticGEO implementa la capa técnica del GEO sobre tu sitio: grafo de conocimiento coherente, entidades ancladas a Wikidata y autoría E-E-A-T conectada. Requiere Yoast SEO: lo extiende, no lo reemplaza.
El Entity SEO es la disciplina que optimiza un sitio para que los motores de búsqueda y los modelos generativos lo resuelvan como una entidad identificable una organización concreta, con atributos verificables y relaciones explícitas en lugar de como un documento que contiene palabras clave. Su mecanismo central es el anclaje: conectar cada concepto, lugar y persona de tu negocio a un identificador que las bases de conocimiento públicas ya reconocen, típicamente un Q-ID de Wikidata. Y aquí está el punto que casi nadie explica: no necesitas que tu empresa tenga entrada en Wikidata para hacer Entity SEO.
El SEO de palabras clave optimiza la coincidencia de texto: qué términos aparecen en tu página y con qué frecuencia. El Entity SEO optimiza la resolución de identidad: si el motor puede determinar sin ambigüedad quién eres, qué sabes hacer, dónde operas y quién te respalda. El primero compite por posiciones en una lista de resultados; el segundo compite por ser la fuente que un modelo generativo elige citar.
Una entidad, en el vocabulario de datos enlazados, es cualquier cosa singular y distinguible: una empresa, una persona, una ciudad, una disciplina profesional, un producto. Google construyó el Knowledge Graph en 2012 precisamente para dejar de tratar las consultas como cadenas de caracteres y empezar a tratarlas como referencias a entidades. Trece años después, los motores generativos heredaron ese modelo y lo llevaron al extremo: no clasifican páginas, resuelven entidades y luego citan a quien mejor las representa.
La diferencia práctica se ve en una sola línea de código. Esto es SEO de palabras clave aplicado a datos estructurados:
"knowsAbout": ["logistica", "Logística", "transporte de carga"]Tres cadenas de texto. Un humano las lee como un solo campo de expertise; una máquina las lee como tres cosas distintas, ninguna de las cuales existe en ninguna base de conocimiento. Esto, en cambio, es Entity SEO:
"knowsAbout": [{
"@type": "Thing",
"name": "Logística",
"sameAs": [
"https://es.wikipedia.org/wiki/Logística",
"https://www.wikidata.org/wiki/Q<ID>"
]
}]Un objeto tipado, con nombre canónico y dos identificadores verificables. Deja de ser una palabra que escribiste y pasa a ser un nodo que el motor ya tenía resuelto antes de conocerte.
Porque los motores generativos seleccionan fuentes por identidad antes que por posición. Un análisis de 153.425 citaciones de IA documentado por OrganiKPI encontró que el 76,95% de las URLs citadas no estaban en el top 10 orgánico de su propia consulta. Traducido: estar bien posicionado no basta, y no estarlo no te excluye. Lo que decide es si el sistema puede identificar y confiar en la entidad detrás del contenido.
Ese dato reordena las prioridades de cualquier estrategia B2B. Durante veinte años, la inversión en SEO se justificaba con una promesa lineal: subes posiciones, subes clics. En un entorno donde tres de cada cuatro citaciones provienen de fuera del top 10, la pregunta relevante cambia de “¿qué posición ocupo?” a “¿existo como entidad resoluble?”.
El mismo cuerpo de investigación cuantifica qué señales de identidad pesan. En un estudio de mayo de 2026 sobre 988 consultas, los perfiles de LinkedIn aparecieron 2.267 veces como fuente de desambiguación de entidades corporativas. No porque LinkedIn sea mágico, sino porque es una referencia externa, estructurada y difícil de falsificar exactamente el tipo de evidencia que un sistema necesita para confirmar que una organización es real.
Si quieres el marco conceptual completo detrás de esta transición, el punto de partida es entender qué es el SEO semántico y cómo opera el Knowledge Graph.
Casi con certeza no calificas, y casi con certeza no importa. Wikidata aplica una política de notabilidad que la mayoría de las PYMEs y consultoras no cumple, y la buena noticia es que el Entity SEO no depende de tener ficha propia: depende de anclar tu empresa a las entidades que ya existen en la base de conocimiento.
Un ítem es admisible si cumple al menos uno de estos tres criterios:
El requisito transversal es la verificabilidad: la entidad debe poder describirse con fuentes fiables, independientes y publicadas por terceros. Una consultora de cinco personas sin cobertura de prensa, sin ficha en bases comerciales y sin registro sectorial no pasa ese filtro. Y si crea la entrada de todos modos, un editor de Wikidata la marcará para eliminación en días.
Wikidata detecta y castiga la autopromoción. Los patrones que activan revisión son conocidos y evitables: cuentas cuyo nombre replica la marca, descripciones con tono comercial, ítems duplicados creados sin verificar si ya existía uno, declaraciones sin referencias externas y cuentas sin historial de edición diverso. Una entrada eliminada no te deja donde empezaste: te deja con un registro público de intento de manipulación asociado a tu marca.
Aquí está el error conceptual que domina las guías en español: asumir que “anclar a Wikidata” significa “tener una entrada en Wikidata”. No es lo mismo. Tu empresa puede ser completamente desconocida para Wikidata y aun así emitir un grafo de conocimiento densamente anclado, porque lo que se ancla no es tu razón social: son los conceptos, lugares y disciplinas con los que tu empresa se declara relacionada. Todos ellos ya tienen Q-ID. Ninguno depende de tu notoriedad.
El anclaje operativo se aplica en tres capas independientes: conceptos (qué sabes hacer, vía knowsAbout y about), lugares (dónde operas, vía areaServed) y personas (quién responde por el conocimiento, vía nodos Person con sameAs). Las tres usan Q-ID de entidades preexistentes. Ninguna requiere que tu marca sea notable.
Cada disciplina, tecnología o servicio que declaras dominar existe ya como entidad. “Derecho laboral”, “soldadura MIG”, “arquitectura de software”, “coaching ejecutivo”: todos tienen Q-ID. Al declararlos como objetos Thing con sameAs doble artículo de Wikipedia más Q-ID de Wikidata tu knowsAbout deja de ser una lista de palabras y se convierte en un conjunto de nodos que el Knowledge Graph puede cruzar con las consultas de los usuarios.
"areaServed": "Región Metropolitana" es una cadena de texto que un motor puede o no interpretar. Un nodo AdministrativeArea con su sameAs anclado es una entidad geográfica que el motor ya tiene ubicada, poblada y jerarquizada dentro de Chile, cuyo identificador Q298 sí es estable y verificable. Para cualquier negocio con cobertura local o regional, esta capa determina si apareces cuando alguien pregunta a una IA por proveedores “en mi región”.
Un nodo Person con jobTitle, alumniOf anclado a la universidad real que sí tiene Q-ID, knowsAbout con entidades verificadas y worksFor referenciando por @id a tu organización es la señal de experiencia más difícil de falsificar que puedes emitir. Es también la capa que la inmensa mayoría de los sitios deja como texto plano en la firma del artículo.
Las tres capas comparten un principio: tu autoridad se construye por asociación verificable con entidades que ya tienen autoridad, no por autodeclaración.
Un Q-ID es el identificador permanente que Wikidata asigna a cada entidad: Chile es Q298. Encontrarlo toma treinta segundos; verificarlo es el paso que casi nadie hace y el único que evita el error más caro del Entity SEO.
sameAs doble solo funciona si ambas URLs resuelven.sameAs roto o redirigido es peor que no declarar nada.Este es el punto crítico de todo el artículo. Si transpones dos dígitos del identificador, ningún validador te avisará. El JSON-LD será sintácticamente perfecto, validator.schema.org lo aprobará sin una sola advertencia, y tu empresa quedará declarando expertise en una entidad completamente ajena. Es un fallo silencioso: no rompe nada visible, solo enseña al Knowledge Graph algo falso sobre ti.
Por eso la verificación no es opcional ni delegable a la intuición. Cualquier proceso serio de Entity SEO valida cada Q-ID contra la API pública de Wikidata antes de emitirlo al grafo. En SemanticGEO ese control está incorporado: el buscador de Wikidata integrado rellena el Q-ID y la URL de Wikipedia ya verificados, y el validador impide guardar un identificador que no resuelva. Los 13 packs de nicho verifican sus identificadores en vivo durante la importación, precisamente porque instalar cien entidades sin comprobar sería multiplicar este error por cien.
sameAs y en qué orden de prioridad?La propiedad sameAs se define en Schema.org como la URL de una página de referencia que indica sin ambigüedad la identidad del ítem. Su función es de consolidación: le confirma al motor que varios perfiles describen la misma entidad real. No todos pesan igual.
sameAssameAs que devuelve 404 o salta a otro destino es peor que su ausencia: introduce ruido en la resolución.@id se parta en dos entidades separadas dentro del mismo grafo.sameAs solo en la portada. Si tus artículos no heredan la identidad de la organización, cada pieza de contenido queda huérfana.Organization. Confunde dos entidades distintas: la persona va en el nodo Person, referenciado por @id.La mayoría de los sitios está en el nivel 1 creyendo estar en el nivel 3, porque su schema valida sin errores. Validar no es anclar. Estos son los tres estados reales que se encuentran en auditoría.
sameAs simpleThing con una URLPlace sin identificadorThing con sameAs doble: Wikipedia + Q-IDAdministrativeArea y City ancladas con Q-IDLa fila decisiva es la penúltima: los tres niveles validan sin errores. Ningún validador distingue entre anclar bien, anclar mal y no anclar. Esa es la razón por la que tantos sitios técnicamente correctos son semánticamente invisibles.
«¿Cómo hago que Google reconozca mi empresa como una entidad?» Para que Google reconozca tu empresa como una entidad necesitas tres cosas: un nodo Organization completo y único en tu sitio, con nombre legal, dirección y punto de contacto; perfiles externos verificables declarados en la propiedad sameAs, empezando por LinkedIn y tu registro comercial; y las disciplinas, lugares y personas de tu negocio ancladas a identificadores de Wikidata que ya existen. No necesitas una entrada propia en Wikidata para lograrlo. Google puede tardar semanas o meses en procesar y verificar tus datos estructurados, y no existe ningún plazo garantizado.
Si tu organización tiene cobertura de prensa independiente, ficha en bases comerciales reconocidas o registro sectorial verificable, una entrada en Wikidata es alcanzable. El camino correcto es inverso al que intenta la mayoría: primero se construyen las referencias externas, después se crea el ítem.
La secuencia que funciona:
Mientras ese proceso madura y puede tomar meses, las tres capas de anclaje del capítulo anterior ya están trabajando. Ese es el punto: el Entity SEO no se bloquea esperando la notabilidad.
Porque los formatos de entrega compiten y caducan; la identidad de tu entidad no. La historia reciente de llms.txt lo demuestra con datos: el estándar se propuso en septiembre de 2024, generó cientos de guías de implementación y, según Google, todavía no lo consume ningún sistema de IA.
Las declaraciones son públicas y fechadas. En junio de 2025, John Mueller escribió: “FWIW no AI system currently uses llms.txt”, y sugirió a los responsables de sitios revisar sus propios registros de servidor para comprobarlo. Un año después, en junio de 2026, amplió el diagnóstico: “I don’t think anyone knows – it’s purely speculative for now (the file has existed for years, yet none of the AI systems use it what does it mean?)”. En la misma conversación expresó preferencia por WebMCP como enfoque alternativo, y recomendó crear un llms.txt solo cuando una plataforma de IA que ya te trae clientes reclame que lo necesita.
No que llms.txt sea inútil su costo de implementación es prácticamente nulo y su riesgo, cero, sino que apostar tu estrategia a un formato de archivo es apostar a la variable equivocada. Si mañana WebMCP desplaza a llms.txt, o si aparece un tercer estándar, quien construyó un grafo de entidades ancladas simplemente cambia el renderizador de salida. Quien escribió un archivo Markdown a mano, empieza de nuevo.
Esa es la lógica de fondo del Entity SEO: el activo duradero es la capa de identidad organización, personas, conceptos y lugares resueltos contra bases de conocimiento públicas, y todo formato de entrega, presente o futuro, es una proyección de esa capa. En SemanticGEO el llms.txt no se escribe: se renderiza desde el grafo. Si el estándar cambia, cambia el render, no el dato.
Si quieres ver cómo se compara este enfoque con el resto del mercado, revisamos nueve alternativas en la comparativa técnica de plugins de GEO para WordPress.
Un Q-ID es el identificador permanente que Wikidata asigna a cada entidad del mundo: Chile, por ejemplo, es Q298. Sirve en SEO porque convierte una palabra ambigua en un objeto que el Knowledge Graph de Google ya tiene resuelto, poblado y conectado a otras entidades. Declarar una disciplina con su Q-ID en la propiedad sameAs le dice al motor exactamente a qué concepto te refieres, en lugar de dejarlo interpretando una cadena de texto que podría significar varias cosas.
Sí, y es el caso de la gran mayoría de las empresas. El Entity SEO no requiere que tu marca tenga entrada propia: requiere que las disciplinas, lugares y personas asociadas a tu negocio estén ancladas a los identificadores que ya existen. Tu expertise en derecho laboral, tu cobertura en la Región de Valparaíso y la universidad donde estudió tu fundador sí tienen Q-ID. Anclar a esas entidades construye tu autoridad por asociación verificable, sin depender de tu notoriedad.
Si pones un Q-ID equivocado, tu sitio declara expertise en una entidad ajena y ningún validador te avisará. Es el fallo más peligroso del Entity SEO precisamente porque es silencioso: el JSON-LD queda sintácticamente perfecto y validator.schema.org lo aprueba sin advertencias, mientras el Knowledge Graph aprende algo falso sobre tu organización. La única defensa es verificar cada identificador contra la API pública de Wikidata antes de publicarlo, revisando la descripción del ítem y su propiedad P31.
No existe un plazo garantizado. Google puede tardar semanas o meses en procesar y verificar datos estructurados nuevos, y el reconocimiento como entidad no se activa con un solo cambio sino con la acumulación de señales coherentes: nodo Organization completo, perfiles externos verificables en sameAs, consistencia de nombre en todas las fuentes y referencias de terceros. Desconfía de cualquier proveedor que prometa un plazo concreto; nadie controla ese calendario.
Son capas distintas del mismo problema. El SEO semántico es el marco conceptual: optimizar por significado y no por coincidencia de texto. El Entity SEO es la disciplina técnica concreta dentro de ese marco: resolver y anclar entidades con identificadores verificables. Y el GEO es el objetivo comercial: ser citado por motores generativos. En la práctica, el Entity SEO es el mecanismo por el que el SEO semántico produce resultados de GEO.
SemanticGEO implementa las tres capas de anclaje sobre tu WordPress y las mantiene coherentes en todo el sitio. Requiere Yoast SEO: lo extiende, no lo reemplaza. Puedes revisar el detalle técnico en características del plugin.
Los mejores plugins de GEO para WordPress en 2026 son SemanticGEO (grafo de entidades ancladas a Wikidata sobre Yoast), Schema App (grado enterprise, con costo enterprise), Yoast SEO (base de grafo sólida y llms.txt gratuito) y Rank Math (cobertura amplia de tipos de schema). La diferencia decisiva ya no es cuántos tipos de schema emite un plugin, sino si construye un solo grafo coherente y verificable o bloques JSON-LD aislados que ningún motor generativo puede resolver como entidad.
Un plugin de Generative Engine Optimization (GEO) es una extensión que prepara un sitio WordPress para ser interpretado y citado por motores generativos ChatGPT Search, Google AI Overviews, Perplexity, Gemini mediante datos estructurados, resolución de entidades y archivos de descubrimiento como llms.txt. En la práctica, la mayoría de los plugins que hoy se venden como “GEO” son plugins de schema con una etiqueta nueva.
El dato más elocuente de la categoría: el plugin del repositorio oficial que literalmente se llamaba “Generative Engine Optimization” fue cerrado por WordPress.org el 14 de agosto de 2025 por violación de directrices. Prometía optimización para ChatGPT, Google AI Overview y Gemini. Duró menos de un año publicado.
Ese episodio resume el estado del mercado en 2026: una demanda real, un vocabulario nuevo y una oferta donde la palabra “GEO” en el nombre no garantiza absolutamente nada bajo el capó. Comprar por etiqueta es, hoy, la forma más rápida de instalar un plugin que emite JSON-LD técnicamente válido y semánticamente inútil.
Este artículo evalúa nueve opciones con siete criterios técnicos verificables. Los criterios se explican primero, precisamente para que puedas aplicarlos por tu cuenta a cualquier plugin que aparezca después de esta publicación incluido el nuestro.
Cuando alguien busca “plugin de SEO generativo para WordPress” puede estar buscando dos productos incompatibles entre sí: plugins que escriben contenido con IA (Koala, AI Engine, Bertha AI, los asistentes de redacción de Rank Math y AIOSEO) o plugins de GEO, que preparan tu sitio para ser leído y citado por IA. El primero produce texto; el segundo produce estructura. Confundirlos es el error de compra más frecuente de 2026.
La distinción práctica, en una línea: si el plugin genera párrafos, es una herramienta de contenido. Si el plugin genera @id, sameAs y llms.txt, es una herramienta de GEO.
Ambas categorías son legítimas y no compiten entre sí de hecho se complementan, pero resuelven dolores opuestos. Un sitio con cien artículos redactados por IA y un grafo de conocimiento vacío seguirá siendo invisible para los motores generativos: hay mucho texto, pero no hay ninguna entidad verificable a la que atribuir autoridad. El caso inverso es igualmente estéril: un grafo impecable sobre un sitio sin contenido sustantivo no le da a la IA nada que citar.
Esta comparativa trata exclusivamente de la segunda categoría: infraestructura semántica. Ninguno de los nueve plugins evaluados escribe contenido por ti.
Porque los motores generativos no consumen bloques de datos estructurados: resuelven entidades. Un sitio puede emitir quince bloques JSON-LD perfectamente válidos y seguir siendo, para el Knowledge Graph y para un LLM, una entidad ambigua e indistinguible de sus competidores.
Los tres síntomas que aparecen en casi todas las auditorías:
<script type="application/ld+json">. El resultado son tres o cuatro “organizaciones” distintas en la misma página, sin relación entre sí. El motor no sabe cuál eres."knowsAbout": ["SEO", "seo tecnico", "Posicionamiento web"]. Tres cadenas de texto que un humano lee como un concepto y una máquina lee como tres cosas distintas, ninguna resoluble contra una base de conocimiento.publisher, dentro de provider y dentro de author. Tres copias con diferencias mínimas entre sí generan ruido de desambiguación, no autoridad.Ninguno de esos tres problemas se resuelve añadiendo más tipos de schema. Se resuelven cambiando la arquitectura del grafo. Por eso la comparativa que sigue no cuenta funciones: mide arquitectura.
Siete criterios distinguen un plugin de GEO real de un generador de bloques con nombre nuevo: unidad del grafo, referenciación por @id, anclaje de entidades con identificador verificado, nodo Person de E-E-A-T conectado, cobertura territorial tipada, origen del llms.txt y limpieza en validadores.
@graph o bloques sueltos?La pregunta operativa: abre el código fuente de una página y cuenta los bloques application/ld+json. Si hay más de uno describiendo tu negocio, tu entidad está partida. Schema.org permite un grafo único por página donde todos los nodos conviven y se referencian; los plugins que inyectan bloques independientes obligan al motor a adivinar la relación entre ellos.
@id en lugar de duplicaciónUn grafo bien construido define la organización una vez, con un @id estable (https://tusitio.com/#organization), y desde ahí la referencia en publisher, provider, worksFor y founder. Los plugins que copian el objeto completo en cada posición producen un grafo pesado y con divergencias silenciosas.
sameAs con Q-ID verificadoEste es el criterio que separa el trigo de la paja. Declarar "knowsAbout": "Logística" no ancla nada. Declarar esa misma entidad con doble sameAs artículo de Wikipedia más Q-ID de Wikidata convierte una cadena de texto en un identificador que el Knowledge Graph ya conoce. El matiz crítico: el Q-ID debe verificarse contra la API de Wikidata. Un dígito equivocado no produce un error de validación; produce una asociación con una entidad ajena, que es peor que no declarar nada.
La señal de experiencia que buscan los quality raters de Google y los modelos generativos no es un nombre en la firma del post: es un nodo Person con jobTitle, sameAs a perfiles verificables, knowsAbout anclado y worksFor apuntando por @id a la organización. La mayoría de los plugins emite el autor como texto plano.
areaServed)"areaServed": "Chile" es una cadena de texto. "areaServed": {"@type": "Country", "name": "Chile", "sameAs": "https://www.wikidata.org/wiki/Q298"} es una entidad geográfica resoluble. Para cualquier negocio local o regional, esta diferencia determina si apareces cuando alguien le pregunta a una IA por proveedores “en la Región de Valparaíso”.
Un llms.txt redactado manualmente es una fotografía que caduca. Publicas tres servicios, cambias de cobertura, sumas artículos y el archivo miente. Un llms.txt renderizado desde el grafo de conocimiento no puede desincronizarse, porque no es un documento paralelo: es una proyección del mismo dato.
Pasa la URL por validator.schema.org y por la Prueba de Resultados Enriquecidos de Google. Un plugin que genera avisos de tipos apilados sin sentido semántico (declarar Organization, LocalBusiness y ProfessionalService a la vez, cuando la herencia de Schema.org ya lo implica) está añadiendo ruido, no señal.
El mercado se divide en tres capas: suites SEO generalistas con schema incluido (Yoast, Rank Math, AIOSEO, SEOPress, Squirrly), generadores de schema especializados (WP Schema Pro, Schema & Structured Data for WP) y herramientas de entidades (Schema App, SemanticGEO, LovedByAI). Solo la tercera capa hace GEO en sentido estricto.
Desde $9,90/mes en su versión Premium, gratuito en la base. Yoast es el único de las suites generalistas que construye un @graph unificado y referenciado por @id desde la versión gratuita, y en 2025 incorporó generación nativa de llms.txt. Su archivo lista los 5 posts o páginas actualizados más recientemente en los últimos 12 meses y los 5 términos de taxonomía con más contenido, con actualización semanal vía acción programada.
Su límite: el grafo es correcto pero mínimo —Organization con nombre, logo y poco más— y su llms.txt es puramente editorial: no incluye entidades de negocio, servicios ni cobertura territorial. Es una base excelente sobre la que construir, no un destino.
Gratuito, Pro desde $7,99/mes. Soporta más de 20 tipos de schema editables directamente en el editor de bloques, lo que lo convierte en la opción más cómoda para marcar contenido variado. Su límite es estructural para GEO: no ofrece anclaje de entidades a bases de conocimiento externas. Marca mucho, resuelve poco.
$99.990 CLP/año por sitio. SemanticGEO no compite con los plugins de SEO convencionales, ya que no se enfoca en la optimización por palabras clave (tarea que ya resuelve perfectamente Yoast). Su propósito es crear entidades digitales y profundizar donde los plugins tradicionales no llegan: proporcionar información estructurada a las IAs y a Google AI Overviews (SGE) mediante un grafo de conocimiento completo.
Con SemanticGEO, incluso las palabras y conceptos semánticos del contenido se anclan con la propiedad sameAs y Q-IDs de Wikidata, transformando texto simple en una entidad verificable. En lugar de duplicar funciones, se engancha a los filtros de Yoast (wpseo_schema_organization, wpseo_schema_graph, wpseo_schema_webpage) y extiende su grafo mediante Graph Stitching: cose nodos Person E-E-A-T, Service, Thing y cobertura territorial regional. Además, renderiza su propio llms.txt dinámico en Markdown con entrega por triple vía y purga automática de cache.
Desde $49,50/año. Su punto fuerte es el schema LocalBusiness con horarios, áreas de servicio e integración con Google Business Profile. Para una PYME con sede física es una compra razonable. Para GEO, la profundidad de sus datos estructurados se queda corta frente a lo que una interfaz conversacional necesita para desambiguar.
$49/año. Cubre múltiples tipos de schema con las funciones avanzadas reservadas a Pro. Buen plugin SEO, sin propuesta de entidades ni llms.txt nativo. No compite en esta categoría; aparece aquí porque muchos sitios ya lo tienen instalado y conviene saber qué no cubre.
Gratuito, Pro desde $9,99/mes. Su enfoque guiado y sus Focus Pages ayudan a quien empieza. Su marcado se limita a schema básico de artículos y requiere mantenimiento manual. Fuera de la conversación GEO.
$69/año o $229 licencia perpetua, sin versión gratuita. Más de 13 tipos de schema con reglas de asignación flexibles. Es el arquetipo del plugin de bloques: excelente si necesitas marcar una receta, un evento o un producto; inadecuado si lo que necesitas es que tu empresa exista como entidad coherente en todo el sitio.
Gratuito, Pro $99/año. Más de 35 tipos, incluidos recetas y video. Misma lógica de bloques por página. Máxima cobertura, mínima cohesión.
Precio a medida. Es la única alternativa del mercado, además de SemanticGEO, que trabaja explícitamente con la propiedad sameAs para conectar entidades a Wikidata y al Knowledge Graph de Google, y añade analítica de rendimiento por entidad integrada con Search Console. Es la referencia técnica de la categoría.
Su límite: es una plataforma SaaS externa, no un plugin autónomo. Tu grafo vive fuera de tu WordPress, con dependencia de proveedor y presupuesto corporativo. Para una agencia con veinte sitios de clientes chilenos, el modelo no cierra.
Gratuito, Pro desde $39/mes. Genera FAQ schema automático, enlazado de entidades a Wikidata y llms.txt automático. Es, junto a SemanticGEO, el planteamiento más cercano a GEO real en formato plugin. Sus límites declarados: no gestiona sitemaps, no incluye investigación de palabras clave ni seguimiento de errores 404 lo que confirma que es una capa complementaria, igual que SemanticGEO y su modelo mensual acumula $468/año, cuatro veces el costo anual de una licencia de SemanticGEO.
La tabla aplica los siete criterios a las cinco opciones que compiten realmente en el terreno de las entidades. Las suites puramente SEO (SEOPress, Squirrly) y los generadores de bloques quedan agrupados en la columna de referencia.
| Criterio | Plugins de bloques (WP Schema Pro, Schema & Structured Data) | Rank Math / AIOSEO | Yoast SEO | Schema App | SemanticGEO |
|---|---|---|---|---|---|
| Grafo unificado por página | No — bloques aislados | Parcial | Sí | Sí | Sí — extiende el @graph de Yoast |
Referenciación por @id | No | Parcial | Sí | Sí | Sí, en todos los nodos |
Entidades ancladas con sameAs | No | No | No | Sí | Sí — doble sameAs (Wikipedia + Wikidata) |
| Verificación de Q-ID contra API | No | No | No | No documentado | Sí — validador en importación |
| Nodo Person E-E-A-T conectado | No | Básico | Básico | Sí | Sí — worksFor, alumniOf, knowsAbout |
areaServed tipado y anclado | No | Texto libre | No | Sí | 16 regiones de Chile con Q-ID + comunas |
| llms.txt | No | No | Sí — solo editorial (5 posts + 5 taxonomías) | No documentado | Sí — renderizado desde el grafo completo |
| Modelo y costo | $69–$229 licencia | Desde $7,99/mes | Gratis / $9,90 mes | SaaS a medida | $99.990 CLP/año por sitio |
«¿Cuál es el mejor plugin de GEO para WordPress?»
El mejor plugin de GEO para WordPress depende de tu base instalada. Si ya usas Yoast SEO, SemanticGEO es la opción más completa: extiende el grafo existente con entidades ancladas a Wikidata por 99.990 pesos chilenos al año por sitio. Si tu presupuesto es corporativo y necesitas analítica por entidad, Schema App es la referencia enterprise. Si aún no tienes ningún plugin SEO, instala primero Yoast o Rank Math: el GEO se construye encima del SEO técnico, nunca en lugar de él.
Los plugins de GEO se descargan desde tres orígenes: el repositorio oficial de WordPress.org (gratuitos y freemium como Yoast, Rank Math y AIOSEO), el sitio del desarrollador mediante archivo ZIP tras la compra (SemanticGEO, WP Schema Pro, las versiones Premium) o una plataforma SaaS externa con conexión por API (Schema App). Desconfía de repositorios de terceros que ofrecen versiones “nulled”: inyectan código y rompen el grafo que intentas construir.
Una advertencia sobre el repositorio oficial: figurar en WordPress.org no es un certificado de calidad semántica. El plugin llamado literalmente “Generative Engine Optimization” estuvo publicado allí hasta ser retirado por incumplimiento de directrices. Revisa siempre fecha de última actualización, número de instalaciones activas y compatibilidad declarada con tu versión de WordPress.
validator.schema.org y guarda el resultado. Es tu línea base: sin ella no podrás demostrar qué mejoró.worksFor y marca las regiones o comunas donde operas.tusitio.com/llms.txt en una ventana de incógnito. Si devuelve 404 pese a estar activado, tienes un conflicto de reescritura o de caché, no un fallo de generación.Casi todos los plugins de GEO del mercado están desarrollados en inglés, para el mercado anglosajón y con soporte en inglés en zona horaria estadounidense o europea. Para un sitio en español y especialmente para uno chileno eso se traduce en tres fricciones concretas: locale mal declarado, cobertura territorial que no reconoce la división administrativa local y soporte técnico en horario incompatible.
Muchas instalaciones de WordPress en Chile emiten og:locale como es_ES o simplemente es, y un atributo <html lang> genérico. Para un motor que intenta determinar a qué mercado sirves, la diferencia entre es_CL y es_ES no es cosmética: es una señal de relevancia geográfica. SemanticGEO incorpora locales regionales reales es_CL, es_AR, es_PE, es_UY, es_CO, es_MX y corrige el atributo de idioma del documento.
Un plugin diseñado en Estados Unidos entiende estados y condados. No entiende regiones ni comunas. Declarar cobertura hiperlocal chilena con esas herramientas implica escribir texto libre exactamente lo que un motor generativo no puede resolver. SemanticGEO trae las 16 regiones de Chile precargadas con Q-ID verificado y permite añadir comunas y ciudades vía buscador de Wikidata, emitidas como nodos City con sameAs.
Cuando un grafo falla en un entorno LiteSpeed con Cloudflare por delante un stack muy común en el hosting latinoamericano, el diagnóstico requiere ida y vuelta técnica. SemanticGEO se desarrolla y se soporta desde Chile, en español, y fue probado en producción precisamente en ese escenario: LiteSpeed más Cloudflare, con raíz sin permisos de escritura.
Ninguna comparativa escrita por un fabricante merece confianza si no declara dónde pierde. Estos son los seis escenarios en los que SemanticGEO no es la respuesta correcta, y decirlos vale más que cualquier argumento de venta.
Una recomendación explícita contra nuestro propio interés comercial: si lo único que buscas es un archivo llms.txt, no compres nada. Yoast SEO lo genera gratis. Es limitado solo contenido editorial pero cubre el caso de uso básico sin costo.
La elección correcta se determina por tres variables: qué plugin SEO tienes instalado, si compites por entidades o por contenido, y si gestionas un sitio o veinte. Estos son los cuatro escenarios más frecuentes.
Empieza por Yoast SEO o Rank Math en su versión gratuita. No compres GEO todavía. Un grafo de entidades sofisticado sobre un sitio sin títulos, metadescripciones ni sitemap es un techo antes de tener cimientos. Vuelve a esta comparativa cuando el SEO técnico esté resuelto.
Este es el perfil de usuario poder de la categoría. Necesitas desplegar una base de entidades coherente por vertical, en minutos y no en jornadas. SemanticGEO resuelve exactamente ese caso con sus packs de nicho verificados; Schema App lo resuelve mejor a escala corporativa, pero su modelo SaaS por cliente rara vez cierra números en carteras de PYME latinoamericana.
Tu ventaja competitiva en motores generativos es el trío LocalBusiness/ProfessionalService + areaServed hiperlocal + E-E-A-T del fundador o especialista. Ese trío es lo que decide si una IA te cita cuando alguien pregunta por un proveedor en tu comuna. AIOSEO cubre la parte local básica; SemanticGEO cubre las tres capas con anclaje verificado.
Tu activo es la autoría verificable. Necesitas un nodo Person real como autor de cada artículo, entidades about y mentions por pieza, y un llms.txt que funcione como carta de presentación ante los crawlers de IA. Yoast te da la base y el llms.txt editorial; SemanticGEO añade la capa de autoría conectada y las entidades por artículo.
Si quieres profundizar en el marco conceptual que sostiene toda esta comparativa, el punto de partida es entender qué es el SEO semántico y cómo funciona el Knowledge Graph.
Necesitas un plugin de GEO si compites por ser citado como entidad, no solo por posicionar contenido. Yoast construye un grafo correcto pero mínimo: identifica tu organización con nombre y logo. Un plugin de GEO añade las capas que los motores generativos usan para desambiguar entidades ancladas con identificador verificable, autoría E-E-A-T conectada, cobertura territorial tipada y servicios como nodos. Si tu sector es competitivo y varios proveedores emiten schema similar, esas capas son la diferencia.
Un Q-ID es el identificador único que Wikidata asigna a cada entidad del mundo: Chile, por ejemplo, es Q298. Importa porque convierte una palabra ambigua en un objeto que el Knowledge Graph de Google ya tiene resuelto. Declarar "knowsAbout": "Logística" no le dice nada a un motor; declararlo con su Q-ID lo conecta a un nodo existente en la base de conocimiento pública. La precisión es crítica: un dígito equivocado te asocia a una entidad ajena sin generar ningún error de validación.
No. Ningún plugin puede garantizar citación en motores generativos, y cualquier proveedor que lo prometa está vendiendo algo que no controla. Los LLM deciden a quién citar con criterios propios, cambiantes y no publicados. Lo que sí se puede hacer es implementar con rigor técnico los factores que estos motores declaran y demuestran consumir: datos estructurados coherentes, entidades resolubles y autoría verificable. Eso mejora tus probabilidades; no compra un resultado.
Puedes, pero en la mayoría de los casos empeora tu situación. Dos plugins de schema independientes inyectan dos bloques JSON-LD que describen la misma organización con datos ligeramente distintos, y el motor debe decidir cuál es la entidad real. La excepción son los plugins diseñados para extender un grafo existente en lugar de emitir el suyo: en esa arquitectura hay un único @graph, más completo, sin duplicación de nodos.
Si el plugin extiende el grafo de tu suite SEO, al desinstalarlo el sitio vuelve al grafo base de esa suite: pierdes las capas añadidas —entidades, cobertura, nodos de servicio— pero conservas la organización, los artículos y el marcado fundamental. Si en cambio usabas un plugin que emitía sus propios bloques, desaparece todo el marcado que ese plugin generaba. Antes de instalar cualquier opción, verifica si ofrece desinstalación limpia y si tus datos migran entre versiones.
SemanticGEO convierte tu WordPress en una entidad que Google y las IAs pueden entender, verificar y citar. La infraestructura definitiva para la Era Generativa.
El SEO Semántico es la práctica de optimizar contenido web basándose en el significado, el contexto y la relación entre conceptos entidades, en lugar de enfocarse únicamente en palabras clave aisladas. Su objetivo es ayudar a los motores de búsqueda a comprender la intención real del usuario y la arquitectura de la información, apoyándose en datos estructurados y en el Knowledge Graph, no en la repetición de términos.
Esta guía explica de dónde viene ese cambio, qué papel juegan hoy la comprensión del lenguaje natural y los datos estructurados, y por qué perseguir solo el ranking en Google ya no basta para que tu contenido sea encontrado ni por un buscador tradicional ni por un asistente de IA.
El SEO Semántico optimiza contenido para que un motor de búsqueda entienda de qué trata realmente una página las entidades que menciona y cómo se relacionan entre sí en lugar de limitarse a detectar coincidencias exactas de palabras clave. El SEO tradicional pregunta “¿esta página contiene la frase exacta que busca el usuario?”; el SEO Semántico pregunta “¿esta página responde la intención detrás de esa búsqueda, sin importar con qué palabras se formule?”.
La diferencia no es cosmética. Una página optimizada solo para palabras clave puede repetir “mejor restaurante Providencia” veinte veces y aun así no responder si un usuario busca “dónde cenar cerca de Tobalaba esta noche”. Una página con estructura semántica conecta ambos conceptos porque entiende que “Providencia” y “Tobalaba” son entidades geográficas relacionadas, y que “cenar” y “restaurante” apuntan a la misma intención de compra.
En 2012, Google publicó el anuncio que marca el origen formal de este enfoque. La compañía explicó que su nuevo Knowledge Graph trataría el mundo como “cosas, no cadenas de texto” (Google, Introducing the Knowledge Graph: things, not strings, mayo de 2012), con más de 500 millones de objetos y 3.500 millones de datos y relaciones entre ellos. Ese fue el primer paso público de un cambio que hoy define cómo Google, Bing, ChatGPT y Perplexity leen cualquier página.
Si ya conoces esta base y quieres ir al siguiente nivel cómo construir y verificar tu propia presencia como entidad frente a la IA, nuestra guía sobre qué es el Entity SEO profundiza en la implementación técnica específica de este mismo principio.
Los motores de búsqueda modernos usan modelos de procesamiento de lenguaje natural (NLP) para interpretar el contexto completo de una consulta, no solo las palabras que la componen. En octubre de 2019, Google anunció BERT y explicó que este modelo mejoraría la comprensión de 1 de cada 10 búsquedas en inglés en Estados Unidos, calificándolo como “uno de los mayores saltos en la historia de Search” (Google, Understanding searches better than ever before, octubre de 2019, Pandu Nayak).
BERT resuelve un problema muy concreto: entender cómo una preposición cambia el sentido completo de una frase. El propio Pandu Nayak usó el ejemplo “2019 brazil traveler to usa need a visa” para mostrar que la palabra “to” no solo “brazil”, “usa” o “visa” determina qué resultado es realmente relevante. Google amplió después este mismo principio con MUM en 2021, un modelo mil veces más potente pensado para responder consultas complejas y multimodales.
Esta capacidad de entender contexto tiene un efecto medible en cómo se comporta el usuario dentro del propio buscador. En consultas informacionales con un AI Overview presente, el CTR orgánico el porcentaje de personas que hacen clic en un resultado cayó de 1,76% a 0,61% entre junio de 2024 y septiembre de 2025, una caída del 61% (Seer Interactive, AIO Impact on Google CTR, actualización de septiembre de 2025).
Esto no significa que el tráfico orgánico desaparezca, sino que cambia dónde se gana la primera impresión: si tu contenido no está estructurado para que un sistema de IA extraiga y cite una respuesta clara, compites por un clic que cada vez ocurre con menos frecuencia.
Una entidad es cualquier persona, lugar, organización o concepto que un motor de búsqueda puede identificar y desambiguar como algo único, independiente del texto exacto usado para nombrarla. El Knowledge Graph de Google es el sistema que almacena estas entidades y sus relaciones, y es la razón por la que el buscador entiende que “Bestsolution” y “agencia GEO en Chile” pueden referirse a la misma organización.
En mayo de 2012, cuando Google presentó el Knowledge Graph, la empresa reportó más de 500 millones de objetos y 3.500 millones de datos y relaciones asociadas entre ellos (Google, Introducing the Knowledge Graph, mayo de 2012). Ese fue el punto de partida: un sistema diseñado explícitamente para dejar de tratar el lenguaje como cadenas de caracteres y empezar a tratarlo como una red de cosas reales conectadas entre sí.
Para tu contenido, esto se traduce en una pregunta práctica: ¿un lector o un modelo de lenguaje puede identificar sin ambigüedad de qué entidades habla tu página y cómo se relacionan con las demás menciones de esa misma entidad en la web? Si tu marca aparece con nombres inconsistentes, sin menciones externas verificables o sin una descripción clara de qué hace, el sistema no tiene con qué construir esa conexión. Profundizamos en cómo estas señales de entidad se conectan con la confianza y el E-E-A-T en nuestro análisis de Knowledge Graph y E-E-A-T para GEO.
No. Los datos estructurados schema markup ayudan a los motores de búsqueda a confirmar el significado de tu contenido, pero no mejoran directamente tu posición en el ranking. La propia documentación oficial de Google es explícita en este punto: el marcado solo habilita que una página sea elegible para aparecer con una función enriquecida; no garantiza que aparezca, y no sustituye la calidad o relevancia real del contenido (Google Search Central, General Structured Data Guidelines).
El 7 de mayo de 2026, Google dejó de mostrar resultados enriquecidos de FAQ en su buscador, después de restringir progresivamente esta función desde agosto de 2023 por el uso masivo de bloques de preguntas genéricos o promocionales que no reflejaban contenido real (Search Engine Land, Google to no longer support FAQ rich results, 2026). Google confirmó que seguirá interpretando el marcado FAQ para entender páginas, pero ya no lo usará para mostrar el snippet visual en el buscador.
Esta es la conexión que pocas guías hacen explícita: el mismo principio que sostiene el SEO Semántico significado real por sobre marcado decorativo es la razón por la que Google terminó retirando una función que muchos sitios usaban para “inflar” su presencia en el SERP sin agregar valor real. El schema correcto sigue siendo útil para que un sistema confirme entidades y relaciones; el schema usado como atajo para ganar espacio visual es exactamente lo que el algoritmo empezó a penalizar.
Por eso, en las auditorías que hacemos en Best Solution, la pregunta nunca es “¿tiene schema?”, sino “¿el schema describe con precisión lo que la página realmente ofrece?”. Un FAQ marcado con schema pero con respuestas vagas no ayuda ni al usuario ni al sistema que intenta citarlo.
La autoridad temática se construye cuando un sitio cubre un tema y sus conceptos relacionados de forma consistente, no cuando publica una sola página muy optimizada. Un motor de búsqueda que entiende entidades también entiende qué otras entidades deberían aparecer mencionadas alrededor de un tema y nota cuando faltan.
Esto es exactamente lo que hace un clúster de contenido bien construido: una página pilar que define el concepto central, y páginas de apoyo que profundizan en subtemas relacionados, todas enlazadas entre sí de forma explícita. Este artículo, por ejemplo, es el pilar de un clúster que conecta con nuestra guía sobre la diferencia entre SEO tradicional y GEO y con el análisis técnico de Entity SEO como implementación específica del mismo principio semántico.
El enlazado interno no es un detalle secundario en esta arquitectura: cada enlace entre páginas del mismo clúster refuerza, para el sistema que lee tu sitio, que esas entidades están relacionadas entre sí de la misma forma en que tú las presentas.
Aplicar SEO Semántico no requiere reescribir todo tu sitio de una vez: se implementa en capas, empezando por la claridad conceptual y terminando por el soporte técnico.
Insertar sinónimos y variaciones sin una estructura de intención detrás sigue siendo optimización por palabras, solo que con más términos. El cambio real está en organizar el contenido alrededor de la pregunta del usuario, no en la densidad de vocabulario.
Un marcado que describe algo que la página no cumple como ocurrió con miles de bloques FAQ genéricos antes de mayo de 2026 no mejora tu presencia: la documentación de Google es clara en que el schema no reemplaza la calidad real del contenido.
Una página excelente, sin enlaces hacia y desde contenido relacionado, le da al sistema menos contexto para confirmar que tu sitio cubre el tema con profundidad.
Si tu marca, tu servicio o tu ubicación aparecen escritos de formas distintas en tu sitio y en menciones externas, dificultas que el sistema los reconozca como la misma entidad.
El Knowledge Graph, los modelos de lenguaje y las reglas de datos estructurados cambian como muestra la propia eliminación del FAQ rich result en 2026, así que la estructura semántica de un sitio necesita revisión periódica, no una sola implementación.
Publicado el 30 de julio de 2026. Los datos de este artículo provienen de fuentes oficiales de Google y de estudios publicados entre 2012 y 2026.
Blinda tu autoridad digital y asegura tu lugar en la Era Generativa. La infraestructura definitiva de Entity SEO está a un clic de distancia.
Ver Planes y Precios Licencia anual por $99.900 / sitio. Sin sorpresas.No las elimina, pero cambia su función: dejan de ser el objetivo principal y pasan a ser una señal más entre varias que ayudan a confirmar de qué entidad y qué intención trata tu contenido. La palabra clave sigue importando para que un usuario formule su búsqueda, pero ya no basta para decidir si tu página responde esa búsqueda.
Ayudan, pero no son obligatorios ni suficientes por sí solos. Según la documentación oficial de Google, el schema markup habilita elegibilidad para funciones enriquecidas y ayuda a confirmar el significado del contenido, pero no mejora directamente el ranking ni compensa contenido de baja calidad.
El SEO Semántico es el principio general: optimizar por significado y contexto en lugar de palabras clave aisladas. El Entity SEO es la aplicación específica de ese principio a la gestión de entidades concretas —tu marca, tus personas, tus servicios— dentro del Knowledge Graph. Uno es la estrategia; el otro, una de sus tácticas centrales.
Google retiró el resultado visual de FAQ el 7 de mayo de 2026 porque el marcado se usaba masivamente en páginas donde las preguntas no reflejaban contenido real, solo buscaban ganar espacio en el SERP. El schema FAQPage sigue existiendo y Google confirmó que continuará leyéndolo para entender páginas, pero ya no genera el snippet visual en los resultados.
El principio es el mismo —significado y contexto sobre coincidencia de texto—, pero el resultado cambia: en 2026, solo el 38% de las páginas citadas en los AI Overviews de Google también rankea en el top 10 orgánico, frente al 76% de mediados de 2025 (Ahrefs, 2026). Una estructura semántica sólida hoy pesa más para la cita de IA que el ranking tradicional por sí solo.
El SEO Semántico no es una técnica adicional que se suma a la lista de tareas de siempre: es el cambio de referencia completo, desde optimizar cadenas de texto hasta optimizar entidades, relaciones e intención. El Knowledge Graph de 2012, los modelos de lenguaje como BERT y MUM, y la reciente eliminación del FAQ rich result en 2026 son etapas del mismo proceso: los sistemas que leen tu contenido cada vez distinguen mejor el significado real de la decoración superficial.